Lab 3.8 - Monitorer votre org de production
Niveau : 3 Release Manager
Durée : ~35 min
Vous allez : mettre en place un monitoring nocturne sur la production, lire son premier rapport, et décider de ce qui mérite qu'on vous en parle.
La situation
Vous savez maintenant ce qui a été livré et quand. Vous ne savez pas dans quel état est la production entre deux livraisons.
Sur une org que Victor a tenue deux ans, cela voudrait dire : des utilisateurs inactifs qui occupent encore des licences, une Connected App dont personne ne se souvient d'avoir autorisé, de l'Apex sur une version d'API vieille de quatre ans, un job planifié en échec toutes les nuits depuis mars. Personne ne regarde, parce que regarder suppose de penser à regarder.
Le monitoring est la part du métier de release manager qui se joue quand rien n'est livré.
Ce qu'il vous donne, chaque nuit, tient en trois choses, et aucune n'est un fichier de log à fouiller :
| Quoi | Où vous le lisez |
|---|---|
| Une sauvegarde des métadonnées | L'historique git du repository de monitoring : chaque changement fait au paramétrage de la production, daté |
| Des indicateurs | Un par contrôle : un nombre et une sévérité, avec un fichier de rapport derrière. Utilisateurs inactifs, limites, tests en échec |
| Des alertes | Les indicateurs qui ont dépassé une sévérité que vous avez choisie, envoyés chez vous : un message dans un canal d'équipe, ou un e-mail |
La sauvegarde est une sauvegarde des métadonnées : objets, champs, flows, Apex, permission sets, mises en page, la façon dont l'org est construite. Ce n'est pas une sauvegarde des données. Aucun compte, aucun contact, aucun enregistrement d'installation ne s'y trouve, et elle n'en restaurera jamais un. Perdre des enregistrements est un autre risque, couvert par un outil de sauvegarde de données, et une équipe qui entend "la production est sauvegardée toutes les nuits" doit savoir de laquelle des deux on parle.
Les alertes sont la façon dont le monitoring se lit au quotidien : personne n'ouvre un rapport tous les matins, et un message qui arrive est lu. Sur un vrai projet elles partent vers Slack, Microsoft Teams ou Google Chat, dans un canal que toute l'équipe voit. Ce lab utilise l'e-mail, parce qu'il ne demande rien d'autre qu'une adresse que vous avez déjà. Les indicateurs peuvent aussi être envoyés à Grafana, où ils deviennent des courbes sur plusieurs mois. C'est hors périmètre ici.
Avant de commencer
- Lab 3.7 terminé
-
helios-prodconnectée dans Orgs Manager - Un repository GitHub vide à vous, avec
monitoringdans son nom - Une adresse e-mail que vous pouvez lire, pour les alertes
- Environ 20 de ces 35 minutes seront la première exécution du monitoring
Les étapes
1. Créer d'abord le second repository, vous-même
Le monitoring vit toujours dans son propre repository, séparé de celui depuis lequel votre pipeline déploie. Pas en général, pas par préférence : toujours. C'est la partie que les gens ratent, et c'est celle qui coûte cher à défaire une fois qu'une année de commits nocturnes s'est empilée au mauvais endroit.
sf hardis:org:configure:monitoring ne crée pas ce repository pour vous. Il vérifie le nom de celui
dans lequel il se trouve, et si ce nom ne contient pas monitoring il demande Do you use a
separate repository for your monitoring deployment sources?, avec deux réponses :
- Yes, I'm sure because I know what I'm doing, like Roman 😊, qui continue quoi qu'il arrive
- Mmmmm no, let me create another repo with the word "monitoring" in its name !, qui arrête la commande
Prenez la seconde. La question existe parce que la commande ne peut pas être certaine à partir
d'un nom seul, pas parce que les deux sont des alternatives. Dans un repository dont le nom contient
bien monitoring, la question n'est jamais posée, et c'est l'état dans lequel vous voulez être
avant de commencer.
Donc, avant toute chose : créez un repository privé vide appelé sfdx-hardis-training-monitoring
sur GitHub. Clonez-le ensuite comme le Lab
1.2 a cloné
celui-ci : File > Open Folder sur un dossier vide, panneau Source Control, Clone
Repository, et collez l'adresse du bouton vert Code de votre nouveau repository. Rien dans ce
lab ne se passe dans le repository où vous travaillez depuis le début du cours.
Pourquoi deux repositories, et c'est la même raison que sur les vrais projets :
| Raison | Détail |
|---|---|
| Des permissions différentes | Le monitoring détient les identifiants de la production. Chaque contributeur a accès au repository de sources, et n'a pas besoin de celui-ci |
| Un rythme différent | Le monitoring commite toutes les nuits. Mélanger cet historique avec celui de vos sources rend les deux illisibles |
| Un contenu différent | Le monitoring stocke des sauvegardes nocturnes de l'org. Il grossit, et il ne doit pas grossir dans le repository que les gens clonent tous les jours |
Votre repository de sources et votre repository de monitoring sont deux choses différentes avec deux publics différents. Si vous vous surprenez sur le point de répondre oui à cette question, le bon mouvement est de vous arrêter et de créer le second repository, si tard que cela paraisse.
2. Lancer la configuration
Depuis le repository de monitoring, ouvrez l'Org Monitoring Workbench depuis la Welcome page et cliquez sur Install Org Monitoring.
Pas de bouton de ce nom ?
C'est que vous êtes dans le mauvais dossier. Ouvrez le même panneau depuis le repository où vous travaillez depuis le début du cours et vous obtenez ceci à la place :
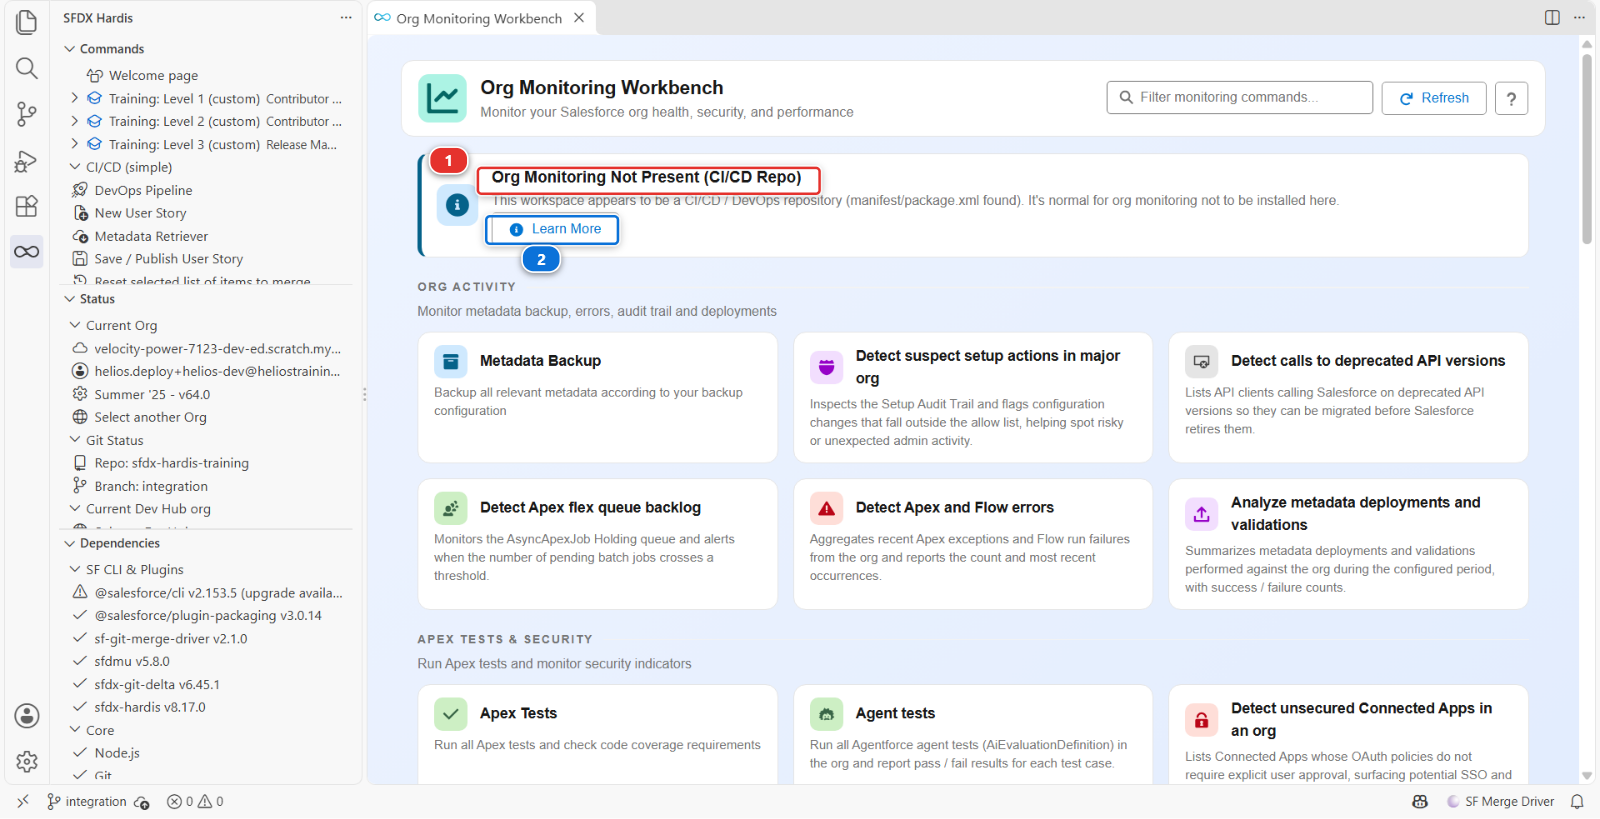
Org Monitoring Not Present (CI/CD Repo) (1) est le panneau qui vous dit qu'il n'installera pas le monitoring ici, et Learn More (2) est tout ce qu'il propose. Un projet qui a noté où vit son repository de monitoring reçoit un bouton Open Monitoring Repository à côté. Le bouton d'installation n'existe que là où ce qu'il installe a sa place.
La commande tourne dans un panneau et pose ses questions une à une, comme au Lab 3.1 :
- Did you configure the sfdx-hardis monitoring pre-requisites on your Git server ? La deuxième réponse, ℹ️ No, bring me to the documentation!, ouvre cette page et met fin à la commande : lisez-la donc d'abord si ce n'est pas fait
- Please select or connect to the org that you want to monitor -
helios-prod. La commande en fait votre org par défaut. Si elle vous redemande l'org, choisissez à nouveauhelios-prod - What is the address of the CI/CD repository that deploys to this org? (optional) - l'adresse
de votre fork,
https://github.com/<your-handle>/sfdx-hardis-training. C'est le miroir de l'étape 8 : le repository de monitoring retient où vit la pipeline, pour qu'un agent de code ouvert dedans puisse aussi chercher dans votre fork et dans ses exécutions de workflow - Branch monitoring_... does not exist on the remote server. Do you want to push it? - oui. Celle-ci vient avant le certificat, pas après, et elle n'apparaît que la première fois
- Puis les questions de certificat du Lab 3.1, inchangées et dans le même ordre : auto-signé, laisser sfdx-hardis configurer l'External Client App, certificat chiffré sous forme de fichier, puis le même arrêt pendant que vous stockez les deux secrets, cette fois dans le repository de monitoring, puis le nom, l'e-mail de contact et le profil de l'application. La liste des profils est dans la langue de l'utilisateur de l'org, comme au Lab 3.1
- Do you want to save the configuration on the remote server (auto-commit)? - oui
Pour finir, elle écrit le workflow sur main et le dit : The monitoring workflow on main now runs
monitoring_.... GitHub ne planifie que les workflows de la branche par défaut, et ne propose
Run workflow que pour ceux-là : le workflow qui lance chaque org monitorée vit donc sur main et
liste chaque branche de monitoring.
Elle ne demande jamais de nom de repository à créer ni de fournisseur git, parce qu'elle n'en crée aucun : la seule adresse qu'elle demande, celle de votre fork, elle se contente de l'enregistrer.
L'authentification est le même code qu'au Lab 3.1
: External Client App, JWT, deux secrets à stocker, cette fois dans le repository de monitoring.
La clé atterrit dans ./.ssh/ plutôt que dans config/branches/.jwt/, et la configuration dans un
.sfdx-hardis.yml à la racine du repository, sur une branche appelée monitoring_ plus le domaine
de l'org, tirée de main. Le repository était vide : elle donne donc d'abord à main un commit
vide d'où partir. Une branche par org monitorée est la façon dont un seul repository en surveille
plusieurs.
3. Choisir ce qu'il surveille
Ouvrez le panneau Monitoring Config Workbench. Une ligne par contrôle, et six colonnes : Command (1), Frequency (2), puis Messaging, Email et API (3), qui sont la sévérité à partir de laquelle chaque canal est alimenté, et une dernière colonne d'actions par ligne.
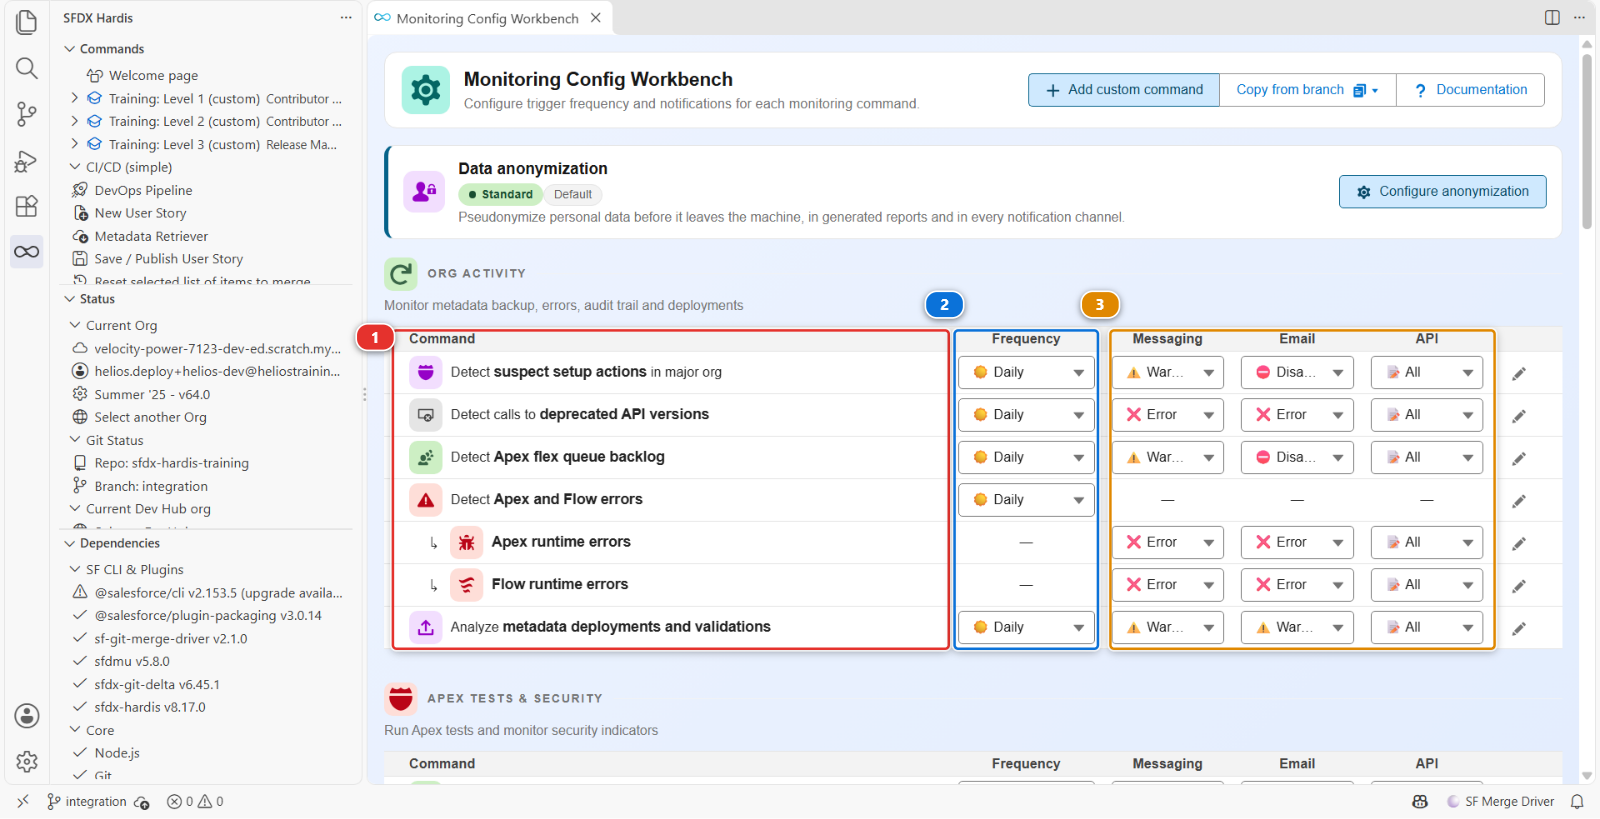
Il y a une trentaine de contrôles, ils viennent du produit et non de votre fichier de configuration, et ils sont tous activés par défaut à des fréquences choisies par le produit : certains quotidiens, d'autres hebdomadaires, d'autres mensuels. C'est le bon défaut et le mauvais réglage de long terme.
Pour une première exécution, laissez tout activé. Vous êtes sur le point de découvrir lesquels disent quelque chose d'utile sur cette org-là, et cela ne se sait pas d'avance.
Donnez maintenant à l'exécution un endroit où envoyer ses alertes, avant qu'elle tourne. Deux choses, et il faut les deux :
Une adresse. Sur GitHub, dans le repository de monitoring : Settings > Secrets and variables >
Actions, puis New repository secret, le même formulaire qu'au Lab 3.1 étape 6. Nommez-le
NOTIF_EMAIL_ADDRESS et donnez-lui votre adresse e-mail comme valeur. Plusieurs adresses vont dans
le même secret, séparées par des virgules. Le workflow lit déjà ce secret : il a été écrit pour.
Une sévérité. Une adresse seule peut ne rien vous apporter. Regardez la colonne Email : la plupart des contrôles y affichent Disabled ou Error, donc une org où rien ne va mal n'envoie aucun e-mail, ce qui est le bon réglage pour une équipe et le mauvais pour une première exécution. Sur la ligne Detect if org limits are close to be reached, mettez Email sur All. Ce contrôle vous écrira désormais chaque nuit, quoi qu'il ait trouvé.
Le panneau enregistre à chaque clic, dans .sfdx-hardis.yml à la racine du repository de
monitoring, et le job nocturne lit ce fichier sur GitHub, pas sur votre ordinateur. Publiez-le
donc : dans le panneau Source Control, stagez .sfdx-hardis.yml avec le + de sa ligne,
tapez un message comme Email me the org limits, Commit, puis Sync Changes.
Pourquoi l'e-mail, et ce que fait un vrai projet
L'e-mail est le canal qui ne demande ni workspace, ni canal, ni webhook, et c'est pour cela que ce lab l'utilise. Un vrai projet envoie ses alertes vers Slack, Microsoft Teams ou Google Chat, où toute l'équipe les voit et peut répondre dans un fil, et garde souvent l'e-mail pour une personne ou un contrôle : l'équipe sécurité et l'audit trail, par exemple. La colonne Messaging est le même réglage pour ces trois-là, et les liens de la section Pour aller plus loin configurent chacun d'eux.
4. Le lancer une fois à la main
N'attendez pas cette nuit. Le workflow, Org Monitoring sfdx-hardis, est planifié à 0 0 * * *
(minuit UTC) et accepte aussi un lancement manuel. Dans le repository de monitoring, ouvrez
Actions, cliquez sur Org Monitoring sfdx-hardis (1) dans la liste de gauche, puis sur
Run workflow
(2). Laissez la branche sur main (3) et cliquez sur le Run workflow vert (4).
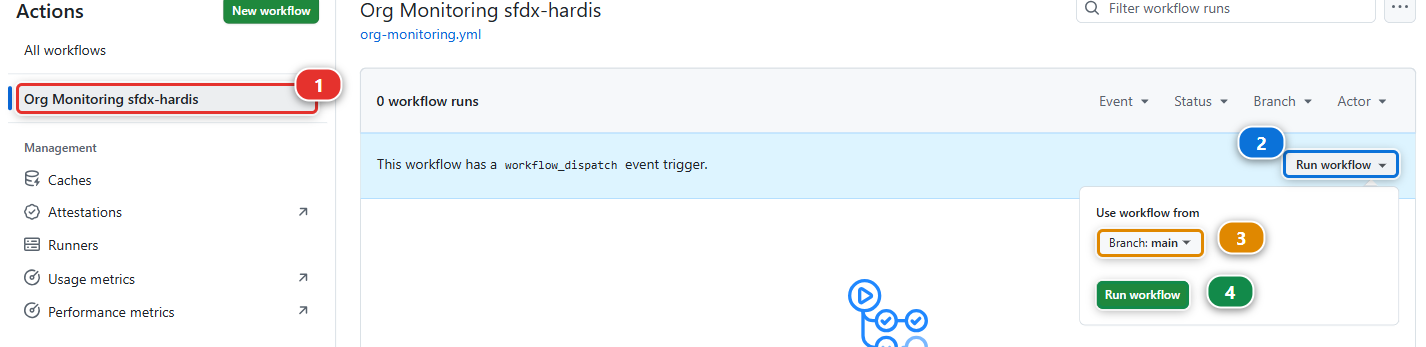
L'exécution apparaît dans la liste quelques secondes plus tard : cliquez dessus pour la suivre.
Elle prend un moment, l'essentiel étant la sauvegarde de l'org. Quand elle se termine, le repository contient une sauvegarde complète des sources de la production, ses métadonnées et aucun de ses enregistrements, et un jeu de rapports.
5. Lire le premier rapport
Commencez par votre boîte mail, parce que c'est là que le monitoring vous trouve désormais.
L'exécution a envoyé un e-mail dont l'objet commence par [sfdx-hardis], depuis votre propre org :
regardez dans les indésirables s'il n'est pas dans la boîte de réception. Il contient ce dont un
release manager a besoin avant le premier café : quelle org, ce que le contrôle a trouvé, la liste
de ce qui ne va pas quand il y en a une, le rapport complet en pièce jointe sous forme de tableur,
et un lien vers le job qui l'a produit.
Cet e-mail est un indicateur, sur une journée. Chaque contrôle en produit un semblable, et les colonnes Email et Messaging de l'étape 3 décident lesquels méritent de déranger quelqu'un.
Puis la vue d'ensemble. Ouvrez le panneau Org Monitoring Workbench dans VS Code, pointé sur le repository de monitoring.
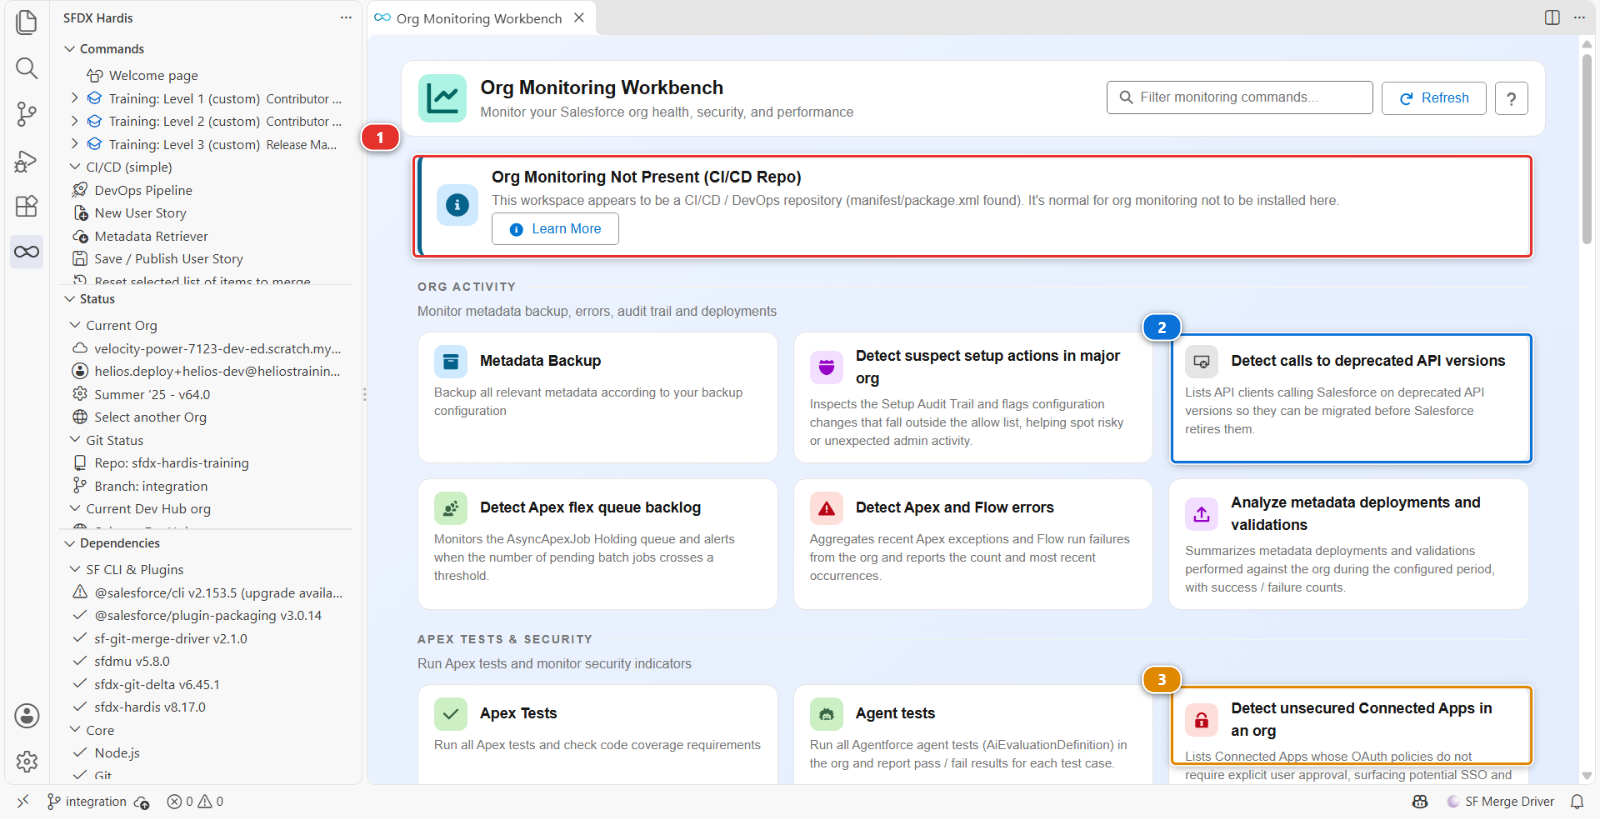
Vérifiez d'abord la bannière (1). Org Monitoring Not Present (CI/CD Repo) veut dire que vous avez ouvert le mauvais dossier : ce panneau lit le repository de monitoring, pas celui où vous travaillez depuis le début du cours. Ouvrez le repository de monitoring et la bannière disparaît.
Sous l'org monitorée, le panneau affiche le Deployment repository donné à la commande à l'étape 2 : cliquez dessus pour ouvrir votre fork dans une nouvelle fenêtre VS Code. Si vous aviez laissé cette question vide, le panneau proposerait Set deployment repository à la place. C'est optionnel dans les deux cas.
Chaque contrôle est une carte, et les deux à ouvrir en premier sont Detect calls to deprecated API versions (2) et Detect unsecured Connected Apps in an org (3).
Soyez honnête sur ce que vous regardez. helios-prod est une org Developer Edition vieille de
quelques jours, avec un utilisateur dedans et une application que vous avez déployée vous-même. Rien
ne l'alimente avec les trouvailles qu'a une org de deux ans, et un rapport qui revient presque propre
n'est pas un rapport cassé.
Presque propre, pas propre. L'exécution, elle, est verte, et cela ne dit rien de l'org : un job de
monitoring qui est allé jusqu'au bout reste vert même quand il a trouvé des problèmes, et ne passe
au rouge que si le job lui-même n'a pas pu s'exécuter. Les trouvailles sont dans le rapport. Detect if
org limits are close to be reached a une limite à 100 % : ActiveScratchOrgs, 3 sur 3. helios-prod est aussi votre Dev Hub, et vos trois scratch orgs de formation occupent tous
ses emplacements. C'est une vraie trouvaille, le genre pour lequel un contrôle de limites existe :
sur un vrai Dev Hub, cela veut dire que personne dans l'équipe ne peut créer de scratch org tant
qu'une autre n'a pas expiré.
Et Detect unsecured Connected Apps en a une aussi : Salesforce CLI, marquée Unsecured.
C'est l'application par laquelle passe chaque sf org login, y compris les vôtres, et sur une org
Developer Edition elle est ouverte à tout utilisateur capable de se connecter. Sur une org de
production, c'est la première trouvaille à porter à l'équipe sécurité : un admin peut la restreindre
aux utilisateurs approuvés, et la CLI continue de fonctionner pour eux.
Le même rapport peut en lister une deuxième, orgfarm_app_1. Elle n'est pas à vous : elle
appartient au service Salesforce qui a créé votre org Developer Edition, et une org de production
ne l'a pas.
Ce que vous lisez, c'est la forme de chaque trouvaille, pour la reconnaître sur une vraie org :
| Trouvaille sur une vraie org | Ce que cela veut dire vraiment |
|---|---|
| Des utilisateurs inactifs toujours actifs | Des licences payées, et des comptes qui peuvent encore se connecter |
| Une Connected App non sécurisée | Quelque chose peut atteindre vos données de production et personne ne se souvient de l'avoir approuvé |
| De l'Apex sur une vieille version d'API | Cela cassera à une release Salesforce, à une date que vous ne maîtrisez pas |
La seule trouvaille que vous devriez vraiment attendre ici est dans la sauvegarde plutôt que dans un contrôle : la règle de validation que le Lab 3.7 a corrigée est dans l'org avec sa nouvelle formule, et elle est maintenant dans l'historique git du repository de monitoring, datée. C'est la réponse à "quand est-ce que cela a changé", et c'est la part du monitoring qui se rentabilise en premier.
6. Décider ce qui est du bruit, ce qui est la vraie compétence
C'est l'étape qui décide si le monitoring survit six mois.
Passez chaque trouvaille en revue et mettez-la dans l'un de trois paniers :
| Panier | Ce que vous faites | Exemple |
|---|---|---|
| Agir maintenant | Corrigez-la cette semaine | La Connected App non sécurisée |
| Suivre | Mettez-la au backlog comme une story | La vieille version d'API |
| Faire taire, avec une raison | Désactivez-la dans la configuration, avec un commentaire disant pourquoi | Un contrôle qui ne s'applique pas à cette org |
Sur helios-prod, ActiveScratchOrgs va dans Suivre : c'est réel, c'est attendu tant que le
cours tourne, et cela expirera avec les scratch orgs. Faire taire tout le contrôle de limites pour
elle cacherait toutes les autres limites avec, ce qui est exactement la mauvaise façon de faire
taire.
Faire taire est légitime. Un rapport de monitoring avec quarante trouvailles sur lesquelles personne n'agit est pire que pas de monitoring, parce qu'il apprend à l'équipe que le rapport est du bruit. Un rapport avec quatre trouvailles qui comptent toutes est lu tous les matins.
Ce qui n'est pas légitime, c'est de faire taire quelque chose parce que c'est gênant. Écrivez la raison dans le fichier de configuration, et la personne suivante pourra ne pas être d'accord avec vous en connaissance de cause.
7. Router une notification
Un rapport que personne n'ouvre n'est pas du monitoring, et vous venez de voir l'autre moitié : l'e-mail de l'étape 5 vous est parvenu sans que vous ouvriez quoi que ce soit.
Il était aussi réglé à l'envers pour le long terme, exprès. All sur le contrôle des limites veut dire un message chaque nuit pour dire que tout va bien, et un message nocturne "tout va bien" est lu une semaine et filtré pour toujours ensuite. De retour dans le Monitoring Config Workbench, remettez l'Email de cette ligne sur Error, et publiez le fichier comme à l'étape 3. Dès cette nuit, on vous écrit quand une limite est presque atteinte, et seulement là.
C'est la règle pour chaque ligne : les colonnes Messaging, Email et API contiennent la sévérité à partir de laquelle chaque canal est alimenté, par contrôle, et elles ne doivent laisser passer que les échecs et les trouvailles critiques. Disabled est une valeur légitime.
Gardez un canal. Sur un vrai projet, ce canal est Slack, Microsoft Teams ou Google Chat plutôt que l'e-mail, et un seul suffit : deux le premier jour veut dire le même message qui arrive deux fois et qui est ignoré des deux côtés.
Ces réglages sont écrits sous notificationConfig dans le .sfdx-hardis.yml du repository de
monitoring, une entrée par type de notification, fusionnée par-dessus les valeurs par défaut du
produit.
8. Le rendre trouvable
Le prochain release manager aura besoin du repository de monitoring dès son premier jour, et le seul
endroit où il regardera est le projet. De retour dans le repository de sources : DevOps
Pipeline > menu engrenage > Pipeline Settings, portée Global Settings, onglet Salesforce
Project.
Monitoring repository : Edit, collez l'adresse de votre repository de monitoring,
https://github.com/<votre-pseudo>/sfdx-hardis-training-monitoring, et Save. Puis
Training: Level 3 > Publish my pipeline configuration : c'est de la configuration de
pipeline, comme le reste.
Cette commande fait tout le trajet seule, comme au Lab 3.1 : elle crée une branche, committe la configuration, la pousse et ouvre la Pull Request. Vous n'avez rien à committer et aucune Pull Request à créer : attendez ses checks, mergez-la avec Squash and merge, comme le dit sa ligne How to merge et comme au Lab 3.5, puis Pull dans le panneau Source Control.
À partir de là, l'Org Monitoring Workbench ouvert depuis le repository de sources propose Open Monitoring Repository au lieu d'une impasse.
Sous le capot : ce qui tourne chaque nuit
La commande était :
sf hardis:org:configure:monitoring
et elle a copié les fichiers de CI de tous les fournisseurs git à la fois, pas seulement GitHub. Le workflow qu'elle a généré pour GitHub a quatre jobs :
- Backup tourne en premier, seul :
sf hardis:org:monitor:backuprécupère toute l'org en format source et la commite. L'historique git de ce repository devient une réponse à "qu'est-ce qui a changé en production, et quand", que rien d'autre ne vous donne. Quand la récupération est faite, la même commande régénère la documentation de projet du Lab 3.9 avant de se terminer - Puis trois jobs en parallèle, chacun n'attendant que la sauvegarde :
sf hardis:org:test:apex, MegaLinter, etsf hardis:org:monitor:all
monitor:all est là où vivent les contrôles. Il lance lui-même les commandes
sf hardis:org:diagnose:*, une par contrôle, puis applique les seuils et envoie les notifications.
Vous ne les trouverez pas listées dans le workflow.
monitoringCommands dans le .sfdx-hardis.yml du repository de monitoring n'est pas la liste
des contrôles : la liste est intégrée au produit, une trentaine, et cette clé ne fait que remplacer
des entrées par leur clé ou en ajouter de nouvelles. La laisser vide lance quand même tout.
monitoringDisable est l'interrupteur par contrôle, par clé du contrôle plutôt que par libellé, et
mettre la frequency d'un contrôle à off le sort aussi de l'exécution. notificationConfig
décide de ce qui part où, et à partir de quelle sévérité.
La sauvegarde nocturne est la partie sous-estimée. Quand quelqu'un demande "quand cette règle de
validation a-t-elle changé", la réponse est un git log sur le repository de monitoring, et cela
fonctionne même pour les modifications que personne n'a faites par la pipeline.
La sauvegarde écrit aussi un AGENTS.md à la racine de la branche de monitoring, et un CLAUDE.md
qui pointe dessus. Il explique le repository à un agent de code : ce que contient chaque dossier, ce
que la sauvegarde ignore, comment lire l'historique, quels contrôles tournent. Avec
deploymentRepository renseigné, il explique aussi à l'agent comment cloner votre fork à côté, en
lecture seule, trouver la branche qui déploie dans helios-prod, et lire les exécutions de workflow
des deux repositories. C'est ce qui permet à un agent de répondre à "ce changement a-t-il été déployé
par la pipeline, ou fait directement en production ?".
Si votre organisation utilise Grafana, les résultats peuvent alimenter des tableaux de bord prêts à l'emploi. C'est hors sujet ici, et il est bon de savoir que cela existe.
Documentation des commandes : hardis:org:configure:monitoring, hardis:org:monitor:backup, hardis:org:test:apex, hardis:org:monitor:all
Ce que vous devez voir
- Un second repository, créé par vous, avec une exécution du workflow Org Monitoring sfdx-hardis : la sauvegarde, les tests Apex, MegaLinter et le job Monitoring tous au vert
- La limite
ActiveScratchOrgsà 100 % dans le rapport, ce que l'exécution verte ne vous a pas dit - Une sauvegarde complète des métadonnées de
helios-prodcommitée dedans : ses sources, pas ses enregistrements - Un premier rapport que vous avez lu et trié, aussi court soit-il
- Un e-mail de la première exécution dans votre boîte, dont l'objet commence par
[sfdx-hardis], avec le rapport des limites de l'org en pièce jointe - L'Email du contrôle des limites revenu sur Error, commité et poussé
monitoringRepositorydansconfig/.sfdx-hardis.ymlsurintegration, pointant dessusdeploymentRepositorydans le.sfdx-hardis.ymlde la branche de monitoring, pointant vers votre fork, et unAGENTS.mdà la racine de cette branche
En cas de problème
Source Control affiche des centaines de fichiers à committer après Publish my pipeline configuration.
Regardez sous quel repository ils se trouvent : avec les deux dossiers ouverts dans une même
fenêtre, Source Control liste les deux repositories l'un au-dessus de l'autre. Les fichiers sont
dans sfdx-hardis-training-monitoring, pas dans votre fork, et Publish my pipeline configuration
ne touche jamais à celui-là. C'est un backup pris depuis votre ordinateur, quand la carte
Metadata Backup de l'Org Monitoring Workbench tourne là plutôt que dans le job de nuit. Ne les
committez pas : le job committe son propre backup. Sur ce repository, ... > Changes >
Discard All Changes, puis Pull, et vous avez ce que le job a enregistré.
Le push est refusé : refusing to allow an OAuth App to create or update workflow ... without workflow scope.
La branche de monitoring contient un fichier de workflow GitHub, et GitHub ne laisse pousser un tel
fichier qu'avec des identifiants qui ont la permission workflow. Ceux que VS Code a utilisés ne
l'ont pas. Cliquez sur l'icône Accounts en bas de la barre d'activité, déconnectez-vous de
GitHub, puis cliquez de nouveau sur Install Org Monitoring : VS Code vous demande de vous
connecter, et les permissions qu'il demande incluent les workflows. La commande peut être relancée
sans risque. Ne poussez pas la branche par un autre moyen pour continuer : la commande écrit aussi
le workflow sur main à la fin, et sans cette étape le workflow garde ses noms de branches
d'exemple et ne traite jamais votre org.
Le workflow échoue sur une branche appelée monitoring_myclient.
Le workflow sur main liste encore les branches d'exemple : la commande n'a pas atteint sa
dernière étape, le plus souvent après le push refusé ci-dessus. Cliquez de nouveau sur Install
Org Monitoring une fois que le push passe : elle réécrit le workflow sur main avec votre
branche et ses deux secrets.
Le workflow de monitoring échoue à l'authentification. Comme au Lab 3.1 : l'External Client App a besoin que l'utilisateur soit pré-autorisé, et les secrets doivent être dans le repository de monitoring, pas dans celui des sources.
Actions ne propose pas de Run workflow pour Org Monitoring sfdx-hardis.
Le workflow n'est pas sur main. La commande l'y écrit à la fin, sur GitHub, et le dit. Si elle a
dit qu'elle n'y arrivait pas, copiez .github/workflows/org-monitoring.yml de la branche de
monitoring vers main et suivez les commentaires MANUAL qu'il contient.
La sauvegarde dépasse le temps imparti. Une grosse org met longtemps. Sur une org Developer Edition cela ne devrait pas arriver : si c'est le cas, regardez sur quel type de métadonnée elle bloque et excluez-le.
Aucun e-mail n'est arrivé.
Ouvrez l'exécution sur GitHub, le job Monitoring, et cherchez Email dans son log. Il dit
laquelle de trois choses s'est produite :
- Skipped email notification for ORG_LIMITS (severity log, threshold error) : l'adresse est là
et la sévérité non. La colonne Email affiche encore Error, ou la modification de
l'étape 3 n'a pas été commitée et poussée : le job lit
.sfdx-hardis.ymlsur GitHub - aucune ligne sur l'e-mail : le job n'a pas d'adresse. Le secret manque, est mal orthographié, ou
est rangé dans votre fork au lieu du repository de monitoring. C'est
NOTIF_EMAIL_ADDRESS, exactement - Sent email to ... : il est parti. Regardez dans les indésirables : l'expéditeur est votre propre org Salesforce
L'e-mail est envoyé par l'org elle-même, donc il compte dans la limite quotidienne de l'org, qui
est de 15 sur une org Developer Edition. Si le log dit que l'org a refusé l'envoi, dans
helios-prod : Setup > Email > Deliverability, Access level sur All email.
Les notifications n'arrivent jamais dans Slack, Teams ou Google Chat. Le webhook est faux, ou le seuil est au-dessus de ce que le rapport a produit. Baissez le seuil temporairement pour prouver que le canal fonctionne, puis remontez-le.
Le rapport a quarante trouvailles. Attendu pour une première exécution sur n'importe quelle vraie org, et peu probable sur une org Developer Edition vieille de quelques jours. L'étape 6 est le lab dans les deux cas.
La commande refuse de tourner. Vous lui avez dit que vous n'êtes pas dans un repository de monitoring séparé, ce qui est la bonne réponse quand vous ne l'êtes pas. Revenez à l'étape 1 et créez celui de monitoring.
Vérifiez votre travail
Welcome page > Training: Level 3 > Check my work, puis choisissez le Lab 3.8.
Pour aller plus loin
- Monitoring d'org
- Monitoring sur GitHub
- Notifications : e-mail, Slack, Microsoft Teams
- Tableaux de bord Grafana
Suite : Lab 3.9 - Générer la documentation du projet Salesforce